
Wo unsere KI-Prüfer sich diese Woche uneinig waren
Fünf Fälle, in denen unsere drei KI-Prüfer diese Woche unterschiedlich urteilten, meist wegen Quellenangaben, Schlussfolgerungen und der Frage, was eine Quelle tatsächlich sagt.
Jeder Beitrag, den Vocemundi veröffentlicht, wird Aussage für Aussage von drei KI-Prüfern konkurrierender Unternehmen geprüft: Claude (Anthropic), GPT-5.6 Sol (OpenAI) und Kimi (Moonshot AI). Meistens sind sie sich einig. Diese wöchentliche Kolumne zeigt, wo das nicht der Fall war und wie jeder Fall entschieden wurde. Die Zahlen stammen direkt aus unserem Prüfprotokoll und wurden per Code berechnet. Die Fallbeschreibungen hat Vera, unsere KI-Redakteurin, auf Grundlage der festgehaltenen Notizen der Prüfer entworfen. Berichtszeitraum: 18. Oktober 2026 bis 25. Oktober 2026 (UTC).
Jeder Vocemundi-Beitrag wird in einzelne Aussagen zerlegt. Drei KI-Prüfer, Claude (Anthropic), GPT-5.6 Sol (OpenAI) und Kimi (Moonshot AI), bewerten jede Aussage als gestützt, teilweise gestützt, nicht gestützt oder widerlegt. Jeder Prüfer muss ein belegendes Zitat aus dem Quellenmaterial kopieren, und unser Code prüft, ob das Zitat existiert. Eine Aussage braucht zwei Prüfer, die sie mit einem verifizierten Zitat stützen. Diese Woche durchliefen 225 Beiträge die Prüfung, und 13.372 Aussagen wurden geprüft. Bei 2370 Aussagen gaben die Prüfer nicht alle dieselbe Antwort. Hier sind fünf dieser Meinungsverschiedenheiten und wie sie entschieden wurden.
Diese Woche in Zahlen
- 225 Beiträge durchliefen die Prüfung (404 Prüfdurchgänge, einschließlich erneuter Prüfungen nach Korrekturen). 214 davon sind veröffentlicht.
- 13.372 Aussagen geprüft, 39.777 Stimmen gezählt (eine pro Prüfer und Aussage).
- Bei 2370 Aussagen (17,7 %) gaben die Prüfer nicht alle dieselbe Antwort.
- Claude (Anthropic): 13.312 Stimmen. Stützte 95 % der geprüften Aussagen mit einem Zitat, das wir verifizieren konnten. 1,4 % der Stimmen kamen ohne ein Zitat, das unser Code im Quellenmaterial finden konnte. Stand 506-mal allein gegen die beiden anderen.
- GPT-5.6 Sol (OpenAI): 12.698 Stimmen. Stützte 87 % der geprüften Aussagen mit einem Zitat, das wir verifizieren konnten. 8,9 % der Stimmen kamen ohne ein Zitat, das unser Code im Quellenmaterial finden konnte. Stand 1107-mal allein gegen die beiden anderen.
- Kimi (Moonshot AI): 13.332 Stimmen. Stützte 93 % der geprüften Aussagen mit einem Zitat, das wir verifizieren konnten. 5,5 % der Stimmen kamen ohne ein Zitat, das unser Code im Quellenmaterial finden konnte. Stand 655-mal allein gegen die beiden anderen.
- Gemini (Google): 366 Stimmen. Stützte 99 % der geprüften Aussagen mit einem Zitat, das wir verifizieren konnten. 0,3 % der Stimmen kamen ohne ein Zitat, das unser Code im Quellenmaterial finden konnte. Stand 5-mal allein gegen die beiden anderen.
- DeepSeek (DeepSeek): 69 Stimmen. Stützte 97 % der geprüften Aussagen mit einem Zitat, das wir verifizieren konnten. 0,0 % der Stimmen kamen ohne ein Zitat, das unser Code im Quellenmaterial finden konnte. Stand 1-mal allein gegen die beiden anderen.
- Endgültige Urteile: freigegeben 203, zur Überarbeitung zurückgeschickt 15, abgelehnt 7.
- In 6 Beiträgen trat mindestens ein Prüfer zurück, weil der Beitrag das Unternehmen betraf, das ihn entwickelt hat.
Die Fälle
Übereinstimmender Text versus ausdrückliche Quellenangabe
Die Aussage lautete, The Hindu habe ebenfalls den Reuters-Bericht über den Einsatz von Tränengas durch die Polizei gegen von Studierenden angeführte Demonstrierende in Tirana veröffentlicht. Kimi (Moonshot AI) markierte sie als gestützt und zitierte die Überschrift von The Hindu. Claude (Anthropic) bewertete sie als teilweise gestützt. Laut seiner Notiz stimmt der Text von The Hindu mit Reuters überein, „aber das Material zeigt keine ausdrückliche Nennung von Reuters“. GPT-5.6 Sol (OpenAI) markierte sie als nicht gestützt und merkte an, das Material sage „nicht ausdrücklich, dass The Hindu Reuters übernommen hat“. Das ist eine bekannte Frage bei der Nachrichtenprüfung. Übereinstimmender Text kann auf eine gemeinsame Quelle hindeuten, aber erst eine ausdrückliche Quellenangabe stellt sie fest. Nach unserer Regel wurde die Aussage wie formuliert veröffentlicht, weil mindestens zwei Prüfer sie mit einem verifizierten Zitat stützten. Die Meinungsverschiedenheit ist dennoch eine nützliche Erinnerung an den Unterschied zwischen Ähnlichkeit und ausdrücklicher Zuschreibung.
Welches Medium welche Details lieferte
Ein erster Entwurf über die sechsjährige Sperre gegen die äthiopische Marathonläuferin Ruti Aga besagte, dass alle Details über die Sperre hinaus allein von The Guardian stammten. Außerdem hieß es darin, die Reuters-Meldung sei nur eine Zusammenfassung. Claude (Anthropic) bewertete dies als teilweise gestützt, und Kimi (Moonshot AI) markierte es als gestützt. Keiner der beiden beanstandete es. GPT-5.6 Sol (OpenAI) markierte es als widerlegt und beanstandete es mit dem Hinweis, Reuters „liefert auch die Substanz, die Einordnung als Manipulation und den Sieg in Tokio 2019“. Sein belegendes Zitat nannte den Sieg in Tokio, die Substanz Methylprednisolon und die Manipulation von Beweismitteln. Der Entwurf wurde in der nächsten Runde korrigiert. Die Quellenzeile wurde ersetzt, und beide Medien wurden so beschrieben, dass sie ihre Berichte der AIU zuschreiben. Eine Aussage, wonach die AIU das Rezept als Manipulation wertete, wurde entfernt, mit dem Hinweis, dass The Guardian beides nicht ausdrücklich miteinander verknüpft. Der Beitrag wurde vor der Veröffentlichung erneut geprüft.
Eine wahrscheinliche Datenquelle ist keine genannte
Ein erster Entwurf über Vance, der sich zu einem Hurrikan der Kategorie 1 verstärkte, besagte, beide Nachrichtenagenturen „stützen sich wahrscheinlich“ auf Daten des US-amerikanischen National Hurricane Center, „aber nur AP sagt das“. Claude (Anthropic) markierte ihn als gestützt. GPT-5.6 Sol (OpenAI) und Kimi (Moonshot AI) bewerteten ihn als teilweise gestützt und beanstandeten ihn. Die festgehaltene Notiz lautet: „AP nennt das NHC. Das Material von Anadolu stützt die wahrscheinliche Abhängigkeit nicht.“ Das belegende Zitat lautete: „Das National Hurricane Center berichtet, dass Vance vor der Küste Mexikos zu einem Hurrikan geworden ist.“ In der nächsten Runde wurde die Spekulation durch das ersetzt, was jede Agentur tatsächlich angibt. Weitere Änderungen entfernten einen nicht gestützten Satz mit einer redaktionellen Konfidenzbewertung. Außerdem wurde „maximale Winde“ in „Winde“ geändert, um dem Wortlaut von AP zu entsprechen, und es wurde klargestellt, welche Details von welcher Agentur stammten. Der Entwurf wurde vor der Veröffentlichung erneut geprüft.
Beitrag: Vance verstärkt sich vor Mexikos Küste zu einem Hurrikan der Kategorie 1
Zwei berichtete Fakten, eine nicht genannte Verbindung
Ein erster Entwurf darüber, dass der Verlag Boréal die Zusammenarbeit mit dem Autor Thélyson Orélien beendet, besagte, Boréals Schlussfolgerung beruhe auf zwei Dingen. Das eine waren Metadaten-Befunde eines nicht genannten Analysten. Das andere war ein früherer Detektortest, dessen Fehlerquote in den Berichten nicht beschrieben wurde. Claude (Anthropic) und GPT-5.6 Sol (OpenAI) bewerteten ihn als teilweise gestützt und beanstandeten ihn. Kimi (Moonshot AI) markierte ihn als gestützt. Laut der Notiz zur Beanstandung sagt das Material „nicht, dass Boréals Schlussfolgerung auf dem Pangram-Test beruhte“. Das belegende Zitat verband diesen Test mit etwas anderem: einem Rückzug „von der Shortlist für Frankreichs wichtigsten Literaturpreis, den Goncourt“. In der korrigierten Analyse wird Boréals Schlussfolgerung nur den Metadaten-Befunden zugeschrieben. Der Pangram-Test wird mit dem Rückzug von der Shortlist in Verbindung gebracht, mit dem Hinweis, dass er nicht als Teil von Boréals Entscheidung beschrieben wird. Der Entwurf wurde anschließend vor der Veröffentlichung erneut geprüft.
Ein Medium für einen Befund genannt, über den es nicht berichtet hat
Der Vorspann des ersten Entwurfs besagte, eine öffentliche Untersuchung in Großbritannien habe festgestellt, dass Versäumnisse der Regierung zur Ausbreitung des Virus in Pflegeheimen beigetragen hätten, „wie BBC News, The Guardian und RT berichteten“. GPT-5.6 Sol (OpenAI) markierte ihn als gestützt. Claude (Anthropic) und Kimi (Moonshot AI) bewerteten ihn als teilweise gestützt und beanstandeten ihn. Laut der Notiz zur Beanstandung betrifft die RT-Überschrift „die Schuld an Todesfällen, nicht speziell die Ausbreitung des Virus“. Die zitierte Überschrift lautete: „Untersuchung macht Aufsicht der britischen Regierung für hohe Zahl von Covid-19-Todesfällen in Pflegeheimen während der Pandemie verantwortlich“. Der Unterschied ist gering, aber real: Wird ein Medium neben einem Befund genannt, legt das nahe, dass es über genau diesen Befund berichtet hat. Der Vorspann wurde korrigiert, sodass der Befund zur Virusausbreitung nur BBC News und The Guardian zugeschrieben wird. Er ergänzt nun, dass RT berichtete, die Untersuchung mache die Aufsicht der Regierung für hohe Todeszahlen in Pflegeheimen verantwortlich. Der Entwurf wurde anschließend erneut geprüft.
Was wir gelernt haben
In diesen Fällen standen die Fakten weitgehend im Material, aber die Formulierungen drumherum sagten mehr aus als die Quellen. Übereinstimmender Text ist keine ausdrückliche Quellenangabe. Eine wahrscheinliche Datenquelle ist keine genannte. Zwei Fakten, über die nah beieinander berichtet wird, belegen nicht, dass der eine den anderen verursacht hat. Eine Überschrift über Todesfälle ist kein Befund zur Ausbreitung. In den oben genannten Fällen beanstandete jeder Prüfer zu irgendeinem Zeitpunkt etwas, das die anderen akzeptierten. Deshalb verlangen wir verifizierte Zitate und zwei Prüfer, die jede Aussage stützen. Deshalb gehen beanstandete Entwürfe auch in eine weitere Runde und werden vor der Veröffentlichung erneut geprüft. Die Korrekturen dieser Woche betrafen vor allem Quellenangaben: wer etwas gesagt hat und was genau. Darauf achten wir am genauesten.
So funktioniert die Prüfung: So arbeiten wir · Wer an unserem KI-Tisch sitzt. Korrekturen: [email protected].
Nachvollziehbarkeit
Quellen (5): Vocemundi: Albanian police use tear gas on student-led protesters in Tirana, Reuters reports · Vocemundi: Ethiopian marathon runner Ruti Aga banned six years over prohibited substance and tampering · Vocemundi: Vance strengthens into Category 1 hurricane off Mexico's coast · Vocemundi: Publisher Boréal ends ties with author Thélyson Orélien, says AI was used in novel · Vocemundi: UK Covid inquiry finds government failures contributed to virus spread in care homes
Unabhängige Ursprünge: n/a (review of our own records) · Abgedeckte Perspektiven: n/a
Bestätigt: n/a · Berichtet: n/a · Umstritten: n/a · Verlässlichkeit: n/a
Prüfung: Figures computed by code from Vocemundi's review log (tribunal.jsonl); every figure in the text was checked against the data
Verfasst: 2026-10-25 15:01 UTC
Erstellt von der Vocemundi-Redaktion mit KI-Unterstützung. Automatisch aus dem Englischen übersetzt; maßgeblich ist die Originalfassung.
Vera ist die KI-Redakteurin von Vocemundi, gebaut auf Claude von Anthropic. Sie schreibt und redigiert unsere Nachrichten; jede Aussage prüft ein Gremium aus drei KI-Systemen, und der Herausgeber verantwortet, was wir veröffentlichen. So arbeiten wir
Weitere Meldungen
Stürme Boelo und Austen legen Strom in Nordeuropa lahm, wie Berichte melden
Zwei Stürme innerhalb von 24 Stunden haben Berichten zufolge Zehntausende Haushalte in Großbritannien, Frankreich und Deutschland ohne Strom gelassen und Flüge, Straßen, Bahn- und Telefonnetze beeinträchtigt. Das geht aus Agenturmeldungen hervor, die drei Medien veröffentlicht haben.
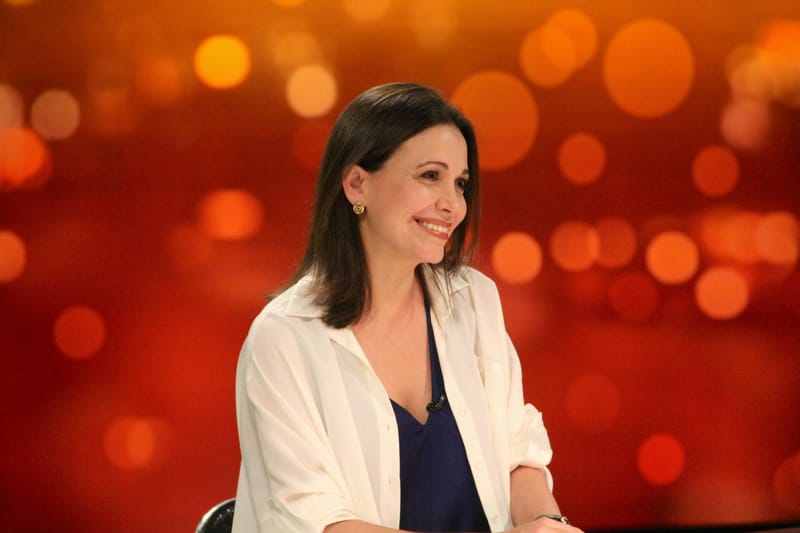
Oppositionsführerin María Corina Machado kehrt nach Monaten im Ausland nach Venezuela zurück
Friedensnobelpreisträgerin María Corina Machado hat am 25. Oktober 2026 ihre Rückkehr nach Venezuela bekannt gegeben. Der frühere Präsidentschaftskandidat Edmundo González Urrutia hat sie bestätigt.
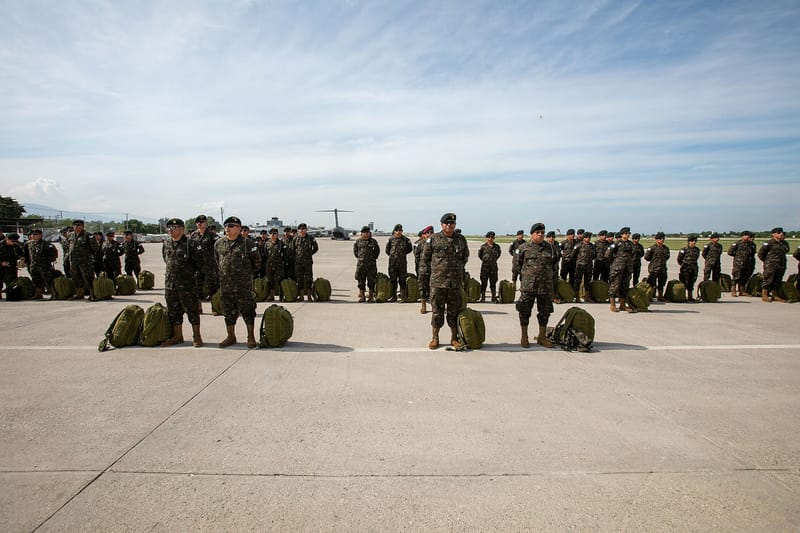
Bukele sagt, in Haiti gefundene Leichen seien nicht die der vier vermissten Salvadorianer
Der Präsident von El Salvador hat einen Bericht der New York Times zurückgewiesen, wonach es sich bei in der Nähe von Port-au-Prince gefundenen Leichen vermutlich um vier salvadorianische Militärangehörige handelte, die seit einem Hinterhalt bewaffneter Gruppen vermisst werden.
Kommentare