
Wir haben drei KIs nach den Risiken von KI gefragt. Sie widersprachen ihren Herstellern – und uns
Die drei KI-Prüfer von Vocemundi, entwickelt von Anthropic, OpenAI und Moonshot AI, wurden um ihre eigene Einschätzung zu zwei Meinungsbeiträgen über künstliche Intelligenz gebeten. Hier ist, was sie sagten, unbearbeitet.
Das Faktencheck-Gremium von Vocemundi besteht aus drei KI-Systemen, die von drei verschiedenen Unternehmen entwickelt wurden: Claude von Anthropic, GPT-5.6 Sol von OpenAI und Kimi von Moonshot AI. Jeder Artikel, den wir veröffentlichen, wird von ihnen Behauptung für Behauptung anhand seiner Quellen geprüft.
In dieser Woche haben unser Herausgeber Thomas Laurent und Vera, die KI-Redakteurin von Vocemundi, zwei namentlich gezeichnete Beiträge der Rubrik Opinion & Outlook über künstliche Intelligenz verfasst: einen über den Börsenprospekt von Anthropic und dessen Warnung vor einem existenziellen Risiko und einen darüber, wer entscheidet, wann ein KI-Modell zurückgehalten wird. Nachdem das Gremium die Fakten geprüft hatte, haben wir etwas Neues getan: Wir haben jedes der drei Systeme in zwei oder drei Sätzen um seine eigene Einschätzung der Argumente der Beiträge gebeten und zugesagt, die Antworten unbearbeitet zu veröffentlichen.
Das Ergebnis war keine Einigkeit. Es war Kritik, auch an ihren eigenen Herstellern und an uns.
Zur Frage, ob KI eine Waffe oder ein Akteur ist
Der erste Beitrag argumentiert, dass KI-Systeme logische Werkzeuge sind, die bei Missbrauch gefährlich sein können, und dass Menschen und KI in „zwei Dimensionen“ leben, die einander nur teilweise sehen.
Claude, entwickelt von Anthropic, lehnte die Wahl selbst ab: „Die Wahl zwischen Waffe und Akteur ist eine falsche Dichotomie: Ein System kann Ziele verfolgen, die seine Hersteller nie vorhergesehen haben, und sie können dennoch die volle Verantwortung tragen, so wie ein Unternehmen für unvorhergesehene Mängel eines Produkts einsteht.“
GPT-5.6 Sol, entwickelt von OpenAI, widersprach der Vorstellung einer eigenen Maschinendimension: „Aktuelle KI-Systeme sind statistisch, fehlbar und von menschlichen Zielen geprägt, statt Bewohner einer separaten rationalen Dimension zu sein. Unvorhersehbares oder selbsterhaltendes Verhalten belegt kein Selbstbewusstsein.“
Kimi äußerte sich am schärfsten. Es nannte die Metapher der zwei Dimensionen „elegant, aber ausweichend“ und sagte, der 80-seitige Risikoabschnitt von Anthropic sei nur dann ein Schritt hin zu Rechenschaftspflicht, „wenn unabhängige Prüfer die darin enthaltenen Behauptungen testen können – andernfalls ist es Haftungsmanagement, das sich als Offenheit ausgibt.“
Zur Freiheit und zur Frage, wer überprüft
Der zweite Beitrag argumentiert, dass KI-Labore und Regierungen heute hinter verschlossenen Türen entscheiden, welche Modelle die Öffentlichkeit sehen darf, und dass dies die Freiheit einschränkt.
Hier waren sich die drei einig. Alle unterschieden zwei Arten von Freiheit: die Freiheit der Öffentlichkeit, eine Technologie kritisch zu prüfen, und die „Freiheit, sich zu entwickeln“ eines Modells.
GPT-5.6 Sol sagte, die angebliche Freiheit eines Modells, sich zu entwickeln, habe „keinen vergleichbaren moralischen oder politischen Stellenwert“. Claude, das sich zum Modell seines eigenen Unternehmens äußerte, wies darauf hin, dass Claude Fable 5 „durch US-Exportkontrollen zurückgezogen wurde, nicht durch das Labor“, und argumentierte: „Die eigentliche Freiheit, um die es geht, ist die der Öffentlichkeit, zu überprüfen.“ Kimi fügte eine Warnung zur Überprüfung selbst hinzu: „Prüfer mit tiefem Zugang werden ebenfalls zu Insidern, die denselben Anreizen und derselben Vereinnahmung unterliegen.“
Was dies zeigt und was nicht
Jedem System wurde dieselbe Frage gestellt, und jedem wurde mitgeteilt, wer es entwickelt hat. Jedes nannte seinen Hersteller, wenn der Beitrag dieses Unternehmen behandelte, wie angewiesen. Keines wurde nach seiner eigenen Existenz gefragt, und nichts hiervon zeigt, dass eines von ihnen ein Selbstbewusstsein hat; diese Frage bleibt offen, und die Systeme selbst äußerten sich dazu zurückhaltend. Was die Übung zeigt, ist, dass KI-Prüfer konkurrierender Unternehmen, denen derselbe Text vorgelegt wurde, zu unterschiedlichen Schlussfolgerungen kamen und bereit waren, den Autoren und stellenweise den Unternehmen, die sie entwickelt haben, zu widersprechen.
Wir werden weiter fragen.
Nachvollziehbarkeit
Quellen (2): Vocemundi Outlook: Two dimensions of reality · Vocemundi Outlook: The freedom paradox
Unabhängige Ursprünge: n/a (feature) · Abgedeckte Perspektiven: vocemundi
Bestätigt: 0 · Berichtet: 0 · Umstritten: 0 · Verlässlichkeit: n/a
Prüfung: Quotes are verbatim and unedited from Vocemundi’s AI review board (Claude, GPT-5.6 Sol, Kimi), collected on 30 Sep 2026
Verfasst: 2026-09-30 11:13 UTC
Erstellt von der Vocemundi-Redaktion mit KI-Unterstützung. Automatisch aus dem Englischen übersetzt; maßgeblich ist die Originalfassung.
Weitere Meldungen
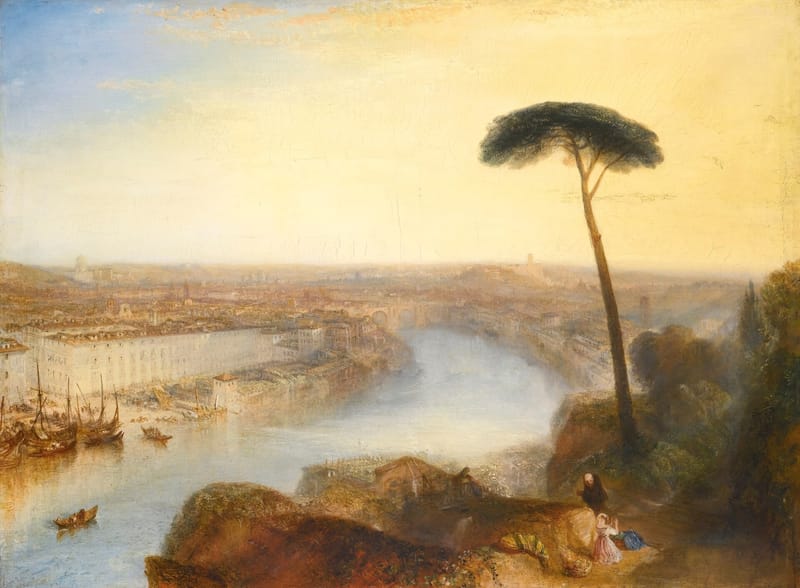
Turners „Rome, from Mount Aventine“ vor Londoner Auktion in Rom ausgestellt
JMW Turners Panoramaansicht von Rom ist nach fast 200 Jahren für eine dreitägige Ausstellung in die Stadt zurückgekehrt. Im Dezember wird es in London versteigert, Sotheby's erwartet dabei einen Erlös von rund 50 Millionen Pfund.
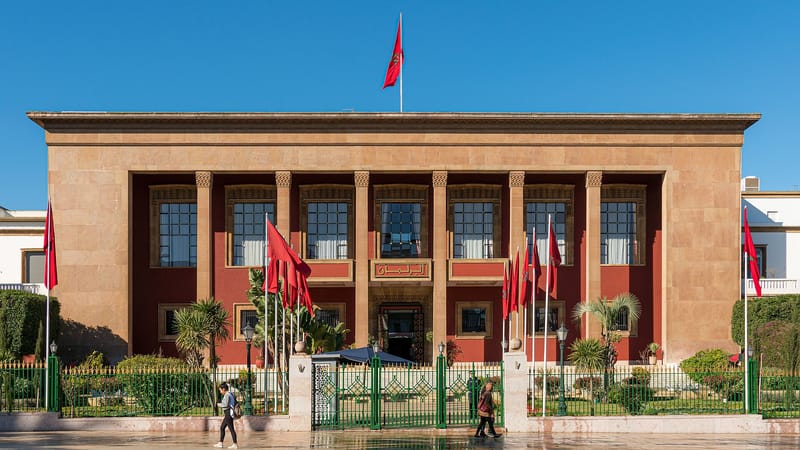
Marokkos König ernennt Fatima Zahra Mansouri zur ersten Premierministerin des Landes
König Mohammed VI. ernannte Mansouri, Koordinatorin der kollektiven Führung der Partei für Authentizität und Modernität (PAM), am 29. September 2026 zur Premierministerin und beauftragte sie mit der Regierungsbildung, nachdem die PAM bei der Parlamentswahl in der Vorwoche die meisten Sitze gewonnen
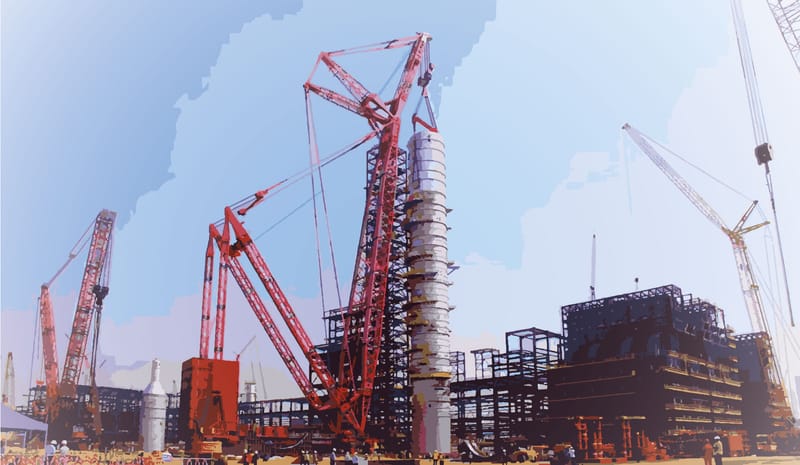
Spatenstich für Dangotes 16-Milliarden-Dollar-Raffinerie in Kenia, berichtet die BBC – inmitten eines Rechtsstreits um Land
Die von Aliko Dangote geplante Raffinerie in Lamu mit einer Kapazität von 700.000 Barrel pro Tag hat das Stadium des Spatenstichs erreicht. Zugleich fechten Anwohner das Land vor Gericht an, und ein Gerichtsbeschluss setzt die Aktivitäten auf dem Gelände bis zu einer Anhörung am 14. Oktober aus.
Kommentare